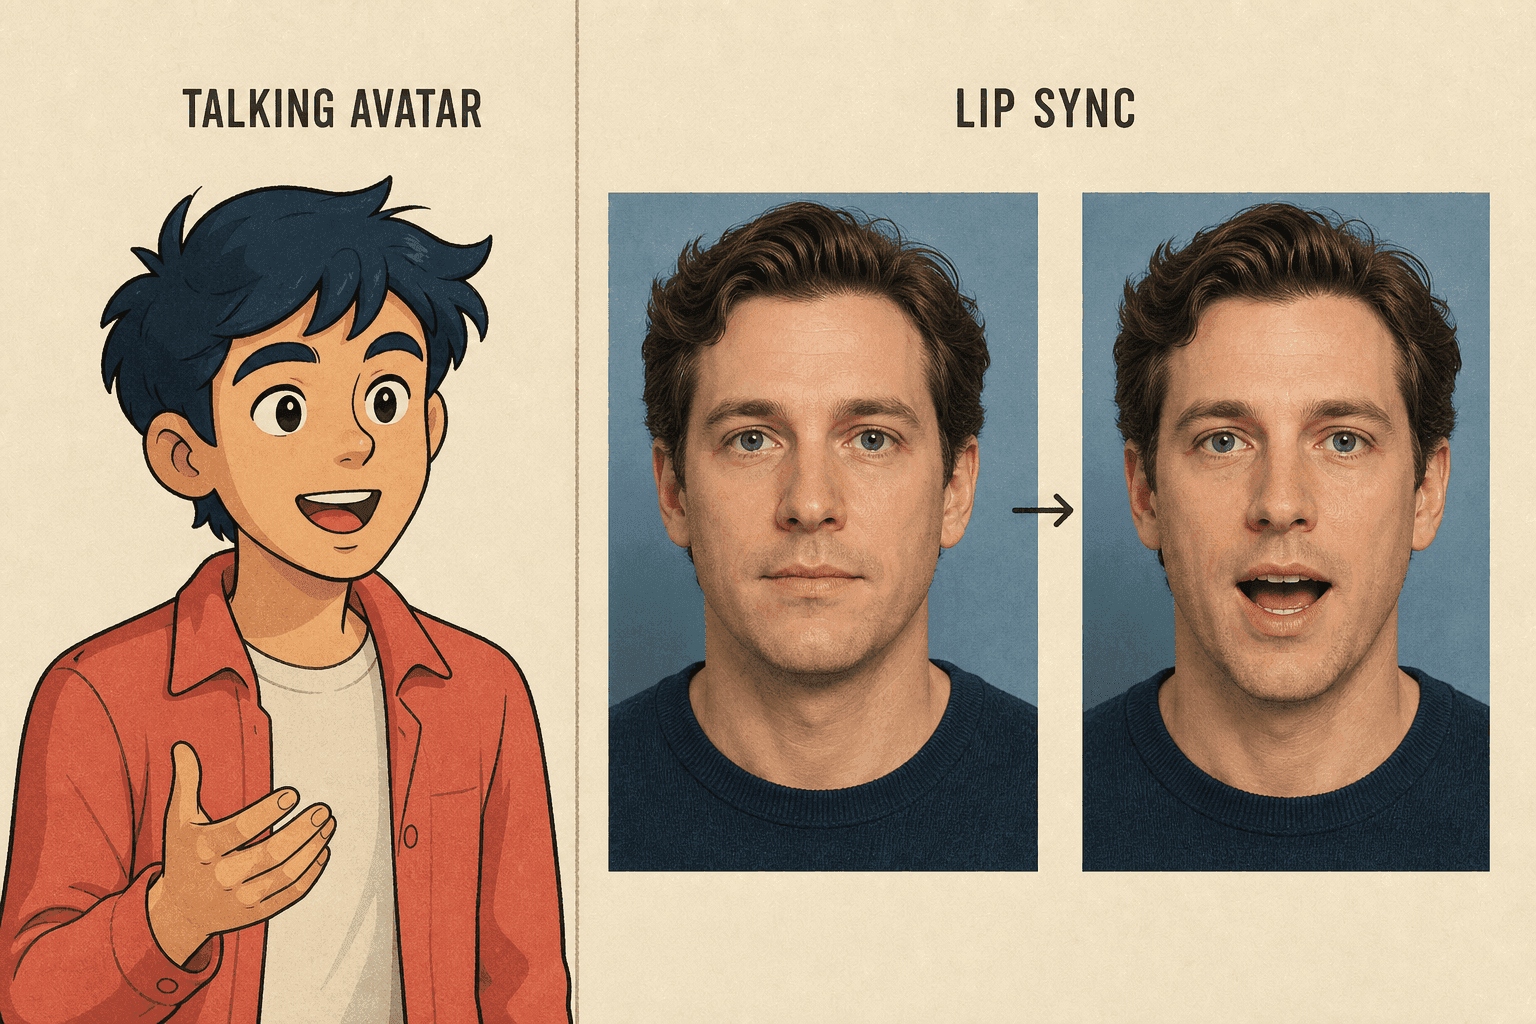
靜態人像需要能建立表演的工具;已有表演的影片通常需要以影片為基礎的唇形同步。 本文把這兩種流程分別稱為「數位化身」與「唇形同步」,但各產品使用的功能名稱可能不同。
依起始素材快速判斷
比較功能名稱前,先看手上的來源素材。靜態圖片需要新增動作;錄好的影片已經包含演技、攝影機運動與場景節奏。
| 判斷項目 | 數位化身 | 唇形同步 |
|---|---|---|
| 常見視覺輸入 | 靜態人像或角色圖片 | 可看見說話者的現有影片 |
| 語音輸入 | 輸入的腳本、生成語音或上傳音訊 | 替換或修正後的音訊 |
| 主要轉換 | 建立一段說話表演 | 重新調整或生成嘴部動作 |
| 通常保留 | 來源角色與整體圖片構圖 | 原始肢體動作、攝影機運動與場景節奏 |
| 主要品質風險 | 身分漂移、動作僵硬、嘴部瑕疵 | 口型不合、邊緣瑕疵、時間漂移 |
| 適合用途 | 照片主持人、吉祥物、寵物、插畫角色 | 配音、在地化、歌曲替換、對白修正 |
如果同時有人像與影片,先決定哪些內容必須保持不變。要保留演技、攝影與節奏,就使用影片;需要全新表達方式,就使用人像。
起始素材會改變整個流程
靜態臉孔與正在動作的說話者,要求系統解決不同問題。這個差異會影響控制方式、失敗類型,以及能保留多少原始表演。
數位化身流程通常如下:
- 上傳或選擇一張人像。
- 加入腳本、生成語音或錄製好的語音。
- 如果功能支援,設定表情或動作。
- 生成嘴巴、眼睛、頭部,有時也包括上半身的動作。
- 檢查新建立的表演。
本文所指的影片優先唇形同步流程,從影片與替換音訊開始:
- 上傳包含清楚臉孔的影片。
- 加入替換或修正後的音訊。
- 必要時,讓新語音長度符合既有剪輯。
- 在現有畫格內生成或調整嘴部動作。
- 檢查新音訊是否符合原始肢體與攝影機運動。
在一般產品用語裡,「音訊驅動化身」可能指其中任何一種結果。不要只依賴分類標籤;請確認工具要的是圖片還是影片、是否建立全新表演,以及會保留來源中的哪些內容。
每種流程會保留什麼
數位化身生成通常會保留圖片中的角色與構圖,但必須建立隨時間變化的行為。系統會決定畫格之間的臉部動作,因此頭部運動與細微表情可能有所變化。
影片優先的唇形同步通常會保留錄製場景、肢體語言、光線變化與攝影機運動。它改動的視覺範圍較小,但嘴部仍需符合新的語音。清楚的原始表演有利於結果;臉部不清楚或新舊語音長度差距太大時,難度會增加。
兩種方法都不會自動比較真實。最好的選擇,是保留專案最不能失去的資訊。
比較控制、速度與失敗模式
兩種流程對語音與動作提供不同控制。有效的比較應聚焦製作任務,而不是哪個功能名稱聽起來更進階。
表演控制: 數位化身能從一張圖片建立說話方式,但可控制的表情與手勢程度因工具而異。唇形同步繼承來源影片中的演技,主要改變語音對齊。
修改速度: 以人像建立的短訊息不需要重新拍攝,可能更容易替換。如果剪輯好的影片已獲批准,只需更換語言或對白,唇形同步可能更快。
時間彈性: 數位化身場景通常能隨新音訊變長或縮短。唇形同步可能必須符合既有剪輯,尤其是切鏡、手勢或畫面事件發生在固定時間時。
視覺穩定: 化身生成必須在新畫格間維持臉部一致。唇形同步則要把改過的嘴部融合進已有光線、動態模糊與轉頭的畫格。
來源依賴: 清楚的人像有利於化身生成;正面且臉孔清楚的表演有利於唇形同步。嘴巴被擋住、臉部太小或快速轉向,都會讓兩種流程變難。
檢查時要提出不同問題:
| 流程 | 檢查問題 |
|---|---|
| 數位化身 | 臉孔是否保持一致?動作是否符合聲音?眼睛與頭部是否自然? |
| 唇形同步 | 新嘴形是否符合原始表情、轉頭、光線與場景節奏? |
依工作內容選擇流程
最好的流程只改變必要內容。 錄好的表演很重要時就保留影片;需要全新表達時才從人像開始。
| 專案 | 主要選擇 | 原因 |
|---|---|---|
| 讓大頭照說歡迎訊息 | 數位化身 | 來源沒有要保留的動作 |
| 讓插畫吉祥物解釋功能 | 數位化身 | 角色以靜態圖片開始 |
| 翻譯錄好的主持人影片 | 唇形同步 | 演技與剪輯已經存在 |
| 替換實拍場景的對白 | 唇形同步 | 應保留身體與攝影機動作 |
| 讓寵物人像說話 | 數位化身 | 任務需要新增臉部動作 |
| 修正影片中少數對不上的字 | 唇形同步 | 只需修復語音對齊 |
| 從角色圖建立唱歌表演 | 若支援圖片與歌聲輸入,選數位化身 | 必須從圖片建立表演 |
| 更換既有表演影片中的歌曲 | 唇形同步 | 原始動作已提供表演 |
如果重要的手部動作、產品示範或攝影機運動必須精準保留,數位化身就不適合。獨立唇形同步有相反限制:除非工具同時支援圖片動作生成,否則不能讓靜態人像動起來。
當現有拍攝表演很重要時,應選擇能保留來源動作的影片優先流程。
長影片可以依場景拆分。以人像建立的主持人可以介紹主題,再用螢幕錄影或B-roll說明細節。只有需要替換語音的實拍片段,才把新音訊同步到原始影片。
兩種流程重疊之處
唇形同步常是數位化身流程的一部分,因為生成的表演仍需要讓嘴巴跟隨語音。這種重疊造成命名混亂:某個產品可能把圖片加音訊功能稱為「唇形同步」,另一個則把同樣結果稱為「會說話的照片」。實際問題仍是:
- 工具接受靜態圖片、影片,還是兩者都接受?
- 除了嘴巴,是否也會建立頭部與臉部動作?
- 可使用文字轉語音、上傳音訊,還是兩者都支援?
- 是否保留現有表演?
- 能否控制長度、表情與取景?
把功能名稱視為標籤,而不是規格。輸入要求與生成結果才會告訴你實際使用的是哪種流程。
適合使用混合流程的情況
有些專案適合同時使用兩種方法,但每次額外生成都可能引入新瑕疵。只有能解決明確製作問題時,混合流程才值得增加複雜度。
一種可能流程如下:
- 使用人像與已核准的來源音訊,生成短版數位化身。
- 將片段剪進包含B-roll、字幕或螢幕錄影的較長影片。
- 畫面剪輯鎖定後,再製作新語言音軌。
- 只對需要新語音的主持人片段套用唇形同步。
- 比較混合結果與直接從原人像重建的結果。
最後的比較很重要。對生成臉孔再次同步,可能累積嘴部瑕疵或降低臉部細節。如果使用新語言重建化身更乾淨,就不需要額外的唇形同步步驟。
只有鎖定剪輯的價值足以抵銷額外處理時,才使用混合流程。不能因為某項功能可用,就增加另一輪生成。
常見問題
唇形同步工具可以讓靜態照片說話嗎?
有時可以。 產品名稱會重疊:影片優先的唇形同步需要現有畫面,另一個平台則可能在圖片型數位化身流程中使用唇形同步。處理靜態照片時,請確認所選功能可同時接受圖片與語音輸入,而且不只重新調整現有嘴形,也會生成臉部動作。
哪種流程更適合動畫角色?
靜態角色使用圖片優先的數位化身;現有動畫片段使用影片優先的唇形同步。 造型化的嘴巴與誇張表情可能影響兩種結果,因此要用短片測試。
兩種流程都接受上傳音訊嗎?
許多工具可以,但支援內容各不相同。 準備最終音軌前,確認支援格式、檔案大小、長度,以及是否需要純語音音訊。
影片配音應該選哪一種?
已有錄製表演時,優先選擇唇形同步。 只有人像,或新語言需要不同節奏與表達方式時,重建數位化身更合適。
保留最重要的來源素材
人像需要重新生成表情與動作;已錄好的說話影片通常只需重新對齊語音。兩種方式都可使用時,保留製作價值最高的素材,只改變專案真正需要的部分。